Dos caminos para hacer hablar a un personaje
- Audio nativo: el propio modelo de vídeo genera la imagen y la voz a la vez. Ideal para escenas cortas con diálogo.
- Voz y lip-sync por separado: primero creas la voz (con ElevenLabs, por ejemplo) y después sincronizas los labios de una imagen o un vídeo con ese audio. Es el camino cuando necesitas una locución más larga o una voz concreta.
Las herramientas en 2026
- ElevenLabs: voces de catálogo en español de España o tu propia voz clonada, con control del tono.
- OmniHuman y otros modelos de lip-sync: convierten una imagen fija y un audio en un personaje que habla con expresiones naturales.
- HeyGen: avatares digitales a partir de un vídeo corto tuyo, muy usados para redes sociales y formación.
En el registro tienes un ejemplo real: un vídeo de redes sociales hecho con mi avatar de HeyGen.
Voz, consentimiento y etiquetado
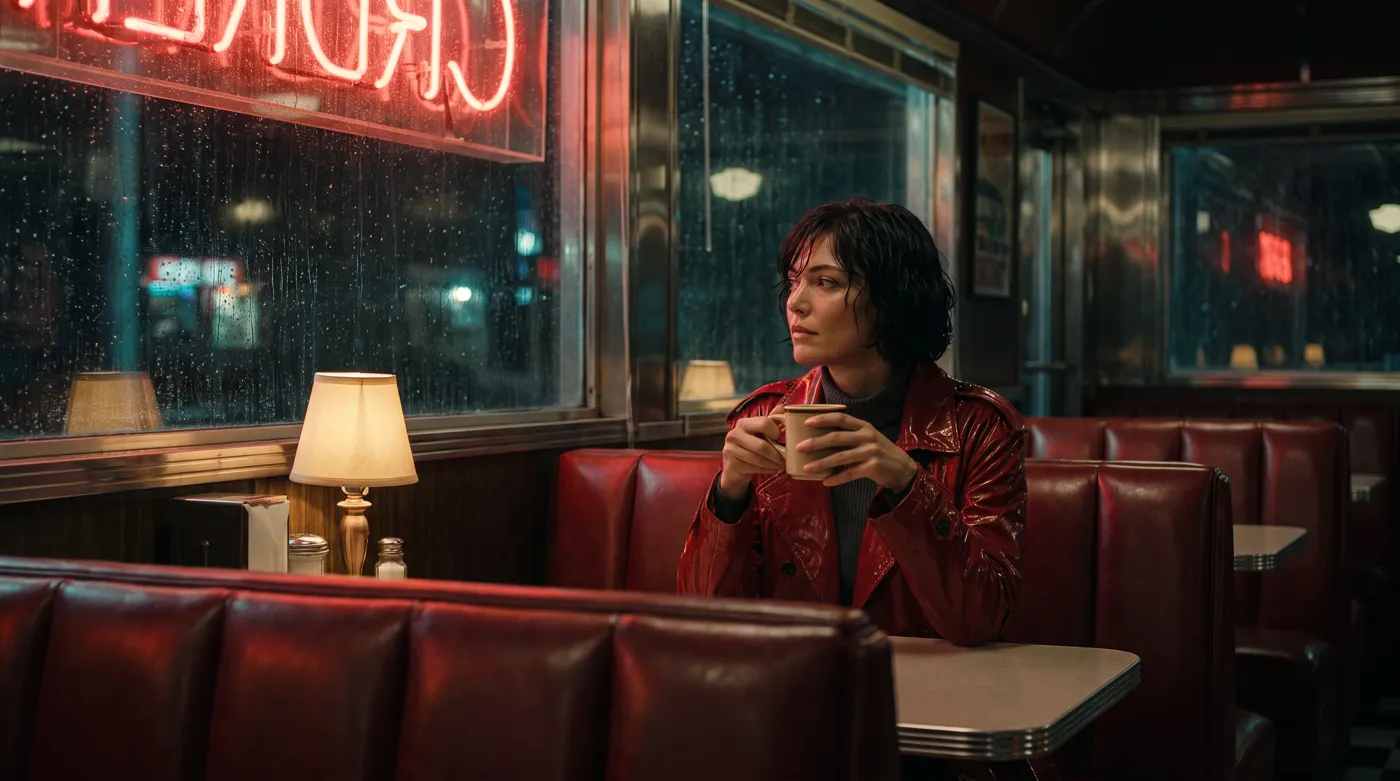
Clonar una voz o usar la cara de una persona exige su consentimiento expreso. Y el Reglamento Europeo de IA obliga a etiquetar los deepfakes desde agosto de 2026. Un avatar de un personaje ficticio, como la detective de esta escuela, evita muchos de esos problemas.
Lo que encontrarás en el libro
El capítulo de audio, voz, música y avatares del libro compara las herramientas de voz, música y lip-sync, y el capítulo de ética y ley te explica qué consentimientos necesitas y cómo etiquetar.
PROMPT DE EJEMPLO
The detective sits in the diner booth at night, speaks calmly and quietly to the camera with subtle natural facial expressions, occasionally glancing at the rain on the window, holding the coffee cup, slight head movements, film noir mood.
Prompt de interpretación para el lip-sync: describe gestos y actitud, no el texto.